chrille@linux:~$ apt show crawlee
Crawlee
Crawlee är ett bibliotek för webbskrapning och webbläsarautomation från Apify. Du bygger skalbara skrapare i JavaScript eller TypeScript med både HTTP och headless-lägen. Det passar dig som regelbundet behöver extrahera data från webben på ett tillförlitligt sätt. Det stöder både HTTP-baserad och headless skrapning.
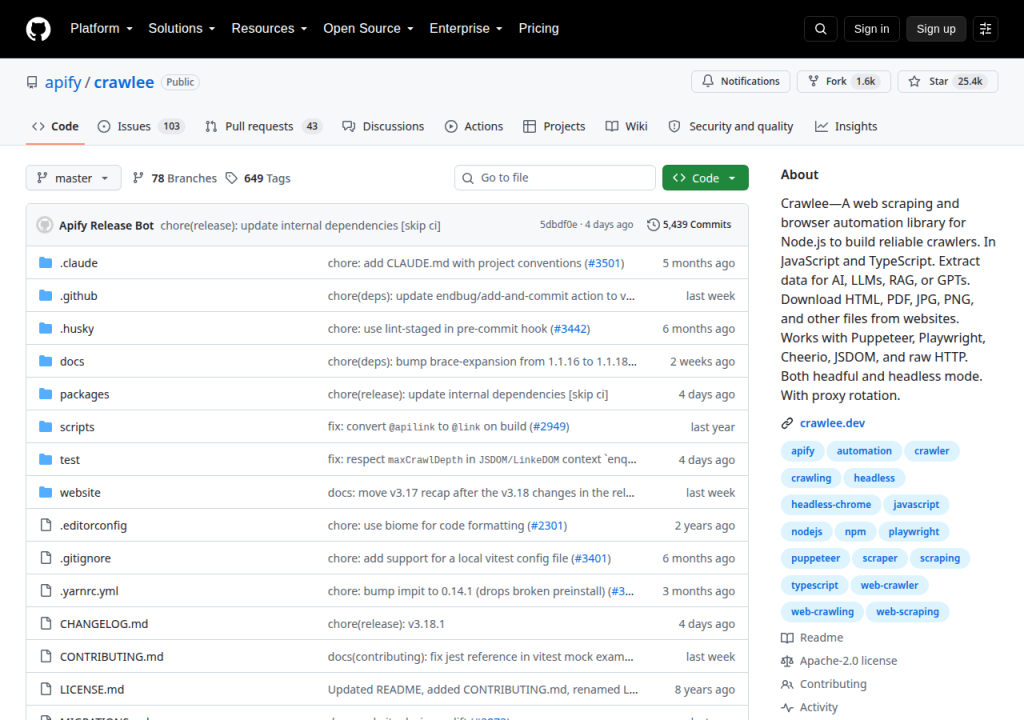
Med Crawlee får du en ram för att skriva skrapare som hanterar köer, lagring, proxyrotation och återförsök. Du kan välja mellan snabba HTTP-baserade skrapor och mer avancerade som kör en riktig webbläsare. Det passar dig som bygger datainsamling i Node.js och vill ha ett etablerat bibliotek med bra dokumentation. Verktyget är öppet och du kan köra det lokalt eller på Apifys plattform. Det är ett praktiskt val för den som regelbundet behöver extrahera data från webben. Det är ett praktiskt val när du behöver samla in data regelbundet och vill att processen ska vara stabil över tid. Det hanterar också proxyrotation och återförsök så att dina skrapare klarar av riktiga förhållanden på webben.
MER UR AI SDKS & AGENTS